Sitemap URL 擷取器
無須手動整理 XML,即可擷取 sitemap 中的每個 URL。
將 sitemap XML 或 sitemap index 轉換為乾淨的 URL 清單,包含來源 sitemap、lastmod、路徑分組、重複項目偵測,以及可直接匯出供抓取規劃使用的資料列。
開啟工具
擷取 sitemap URL、驗證抓取輸入、產生 metadata、建立 AI 可讀的 llms.txt,並在交給 Searvora Spider Analysis 前檢查 canonical、可索引性、robots.txt 與 hreflang 訊號。
將 sitemap XML 或 sitemap index 轉換為乾淨的 URL 清單,包含來源 sitemap、lastmod、路徑分組、重複項目偵測,以及可直接匯出供抓取規劃使用的資料列。
開啟工具
檢查 sitemap 格式、重複項目、跨網域 URL、lastmod 品質、抽樣狀態訊號和下一步抓取動作,避免有問題的 sitemap 成為錯誤輸入。
開啟工具
建立兼顧目標關鍵字、頁面類型、搜尋意圖、品牌契合度和 SERP 可讀性的 title tag 候選內容,不要讓每個頁面都套用相同的通用標題範本。
開啟工具
建立精簡的 llms.txt 草稿,說明哪些公開頁面最重要、網站提供什麼,以及 AI 助理應如何探索 canonical 產品、價格、文件和資源頁面。
開啟工具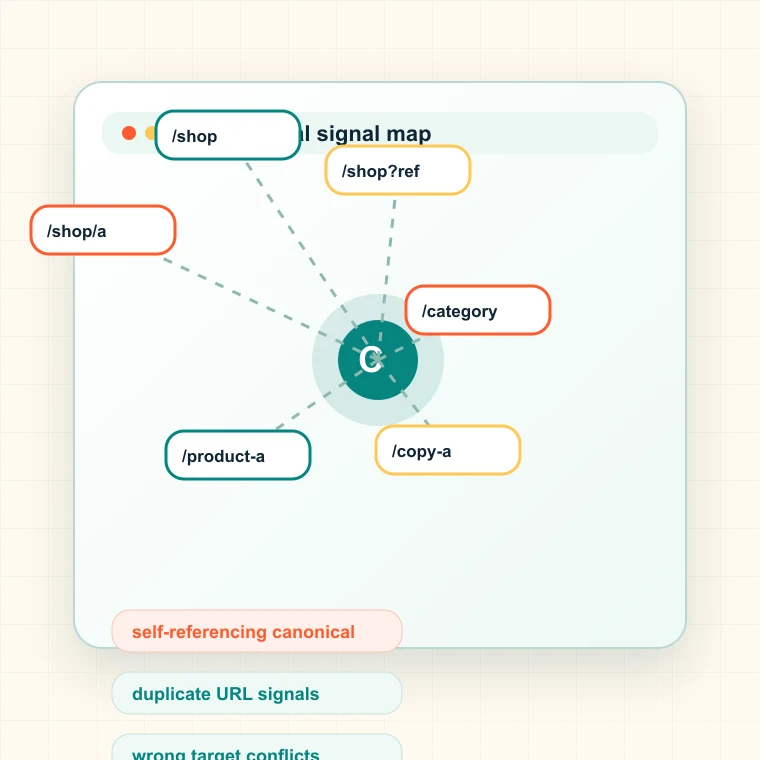
檢查 HTML canonical 標籤、HTTP Link 標頭、自我指向的 canonical、跨網域目標和互相衝突的規則,避免重複頁面分散排名訊號。
開啟工具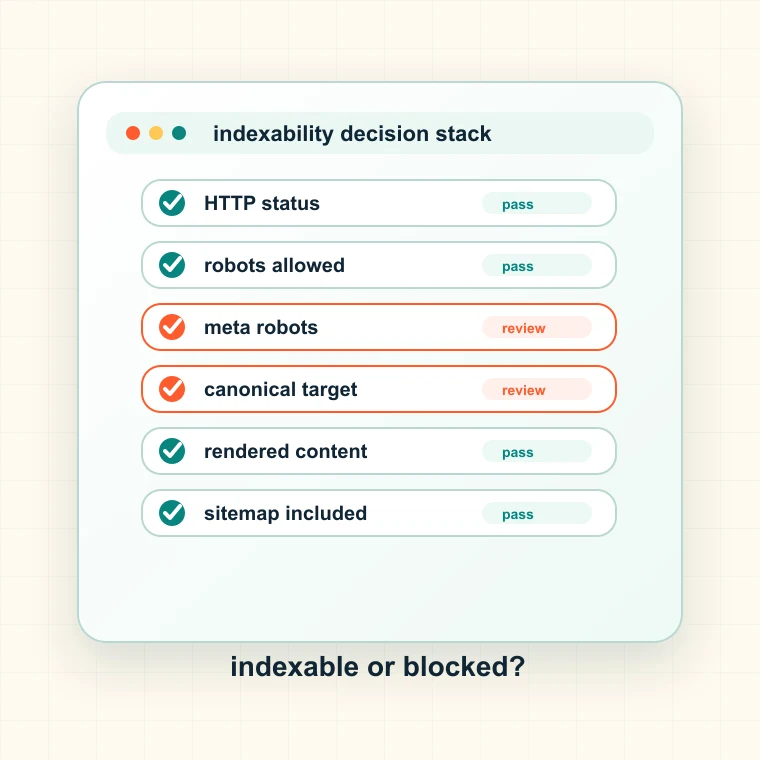
檢查狀態、重新導向、robots.txt 存取權限、meta robots、X-Robots-Tag 和 canonical 訊號,說明頁面為何可以或不可以被索引。
開啟工具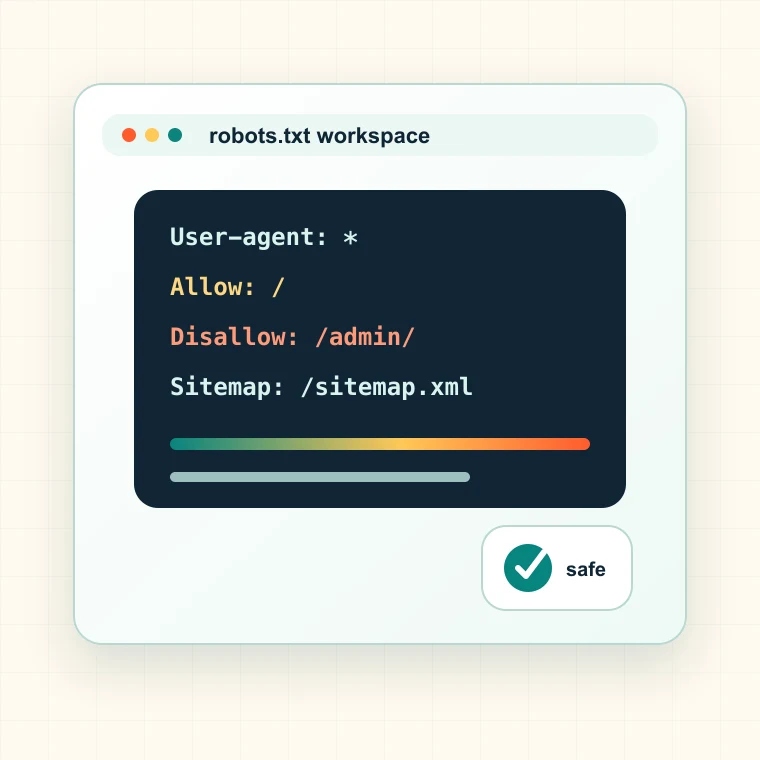
建立能清楚說明爬蟲存取方式的 robots.txt 規則,限制低價值路徑、保留重要頁面並提供 sitemap 探索線索,同時避免封鎖應該被索引的頁面。
開啟工具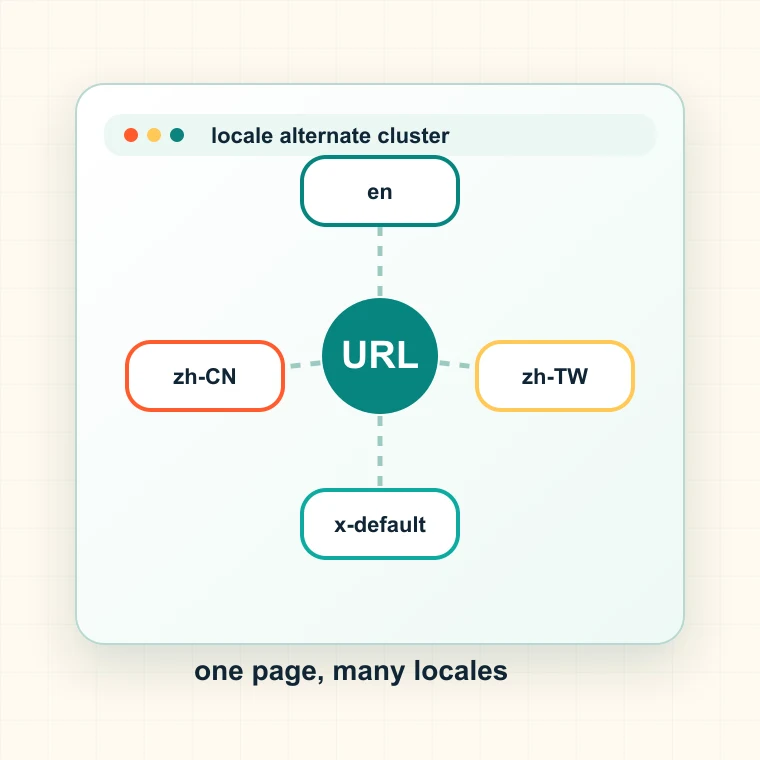
根據手動設定的替代 URL 或 URL 模式產生 hreflang link 標籤,讓本地化頁面將搜尋引擎導向正確的語言、地區和 x-default 備用頁面。
開啟工具