Sitemap URL 抽出ツール
XMLを手作業で整形せずに、サイトマップからすべてのURLを抽出できます。
サイトマップXMLやサイトマップインデックスを、ソースサイトマップ、lastmod、パス別分類、重複検出、クロール計画にすぐ使える行データを備えた整理済みURL一覧に変換します。
ツールを開く
サイトマップURLの抽出とクロール入力の検証、メタデータの生成、AIが読み取れるllms.txtの作成に加え、canonical、インデックス登録可否、robots.txt、hreflangのシグナルを確認し、課題をSearvora Spider Analysisに引き継げます。
サイトマップXMLやサイトマップインデックスを、ソースサイトマップ、lastmod、パス別分類、重複検出、クロール計画にすぐ使える行データを備えた整理済みURL一覧に変換します。
ツールを開く
サイトマップが壊れた入力になる前に、形式、重複、別ドメインURL、lastmodの適切さ、サンプルURLのステータス、次のクロール作業を確認できます。
ツールを開く
すべてのページに同じ汎用テンプレートを当てはめず、ターゲットキーワード、ページの種類、検索意図、ブランドとの適合性、SERPでの読みやすさを考慮したtitleタグ候補を作成します。
ツールを開く
ページが約束する価値を伝え、検索意図に合わせ、適切なCTAを含めながら、どのページにも当てはまる汎用文を避けたディスクリプション候補を生成します。
ツールを開く
公開する重要ページ、サイトが提供する内容、canonicalな製品・料金・ドキュメント・リソースページをAIアシスタントに見つけてもらう方法を、簡潔なllms.txtにまとめます。
ツールを開く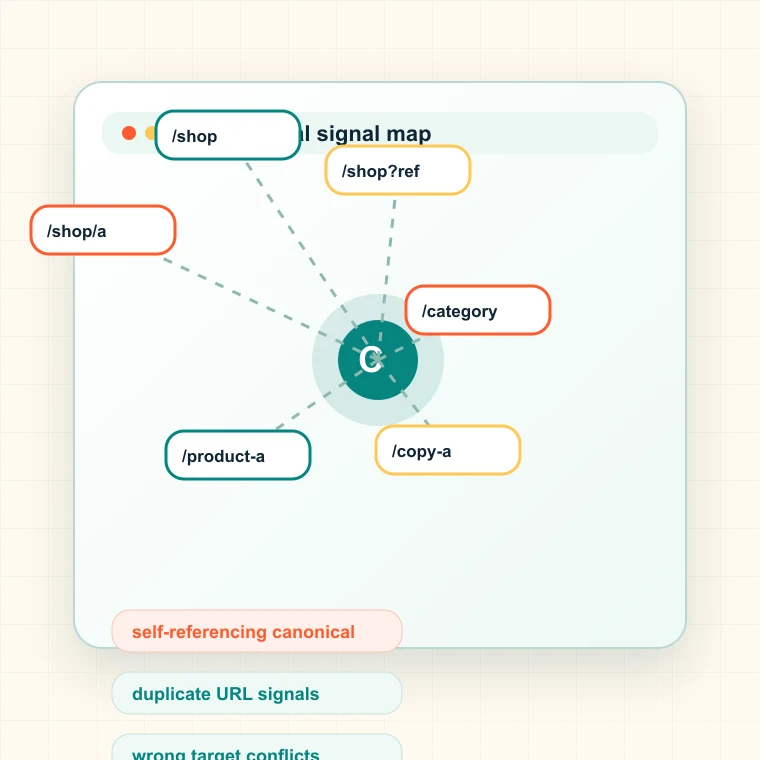
重複ページに検索評価を奪われる前に、HTMLのcanonicalタグ、HTTP Linkヘッダー、自己参照シグナル、別ドメインの指定先、競合するcanonicalルールを調べます。
ツールを開く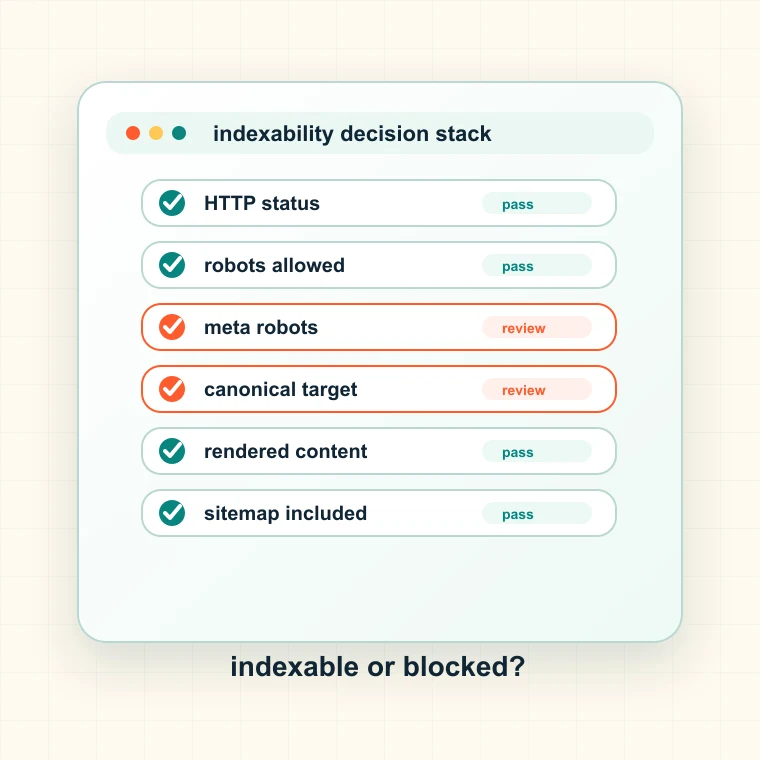
ステータス、リダイレクト、robots.txtへのアクセス、meta robots、X-Robots-Tag、canonicalシグナルを確認し、ページをインデックス登録できるかどうかの理由を説明できます。
ツールを開く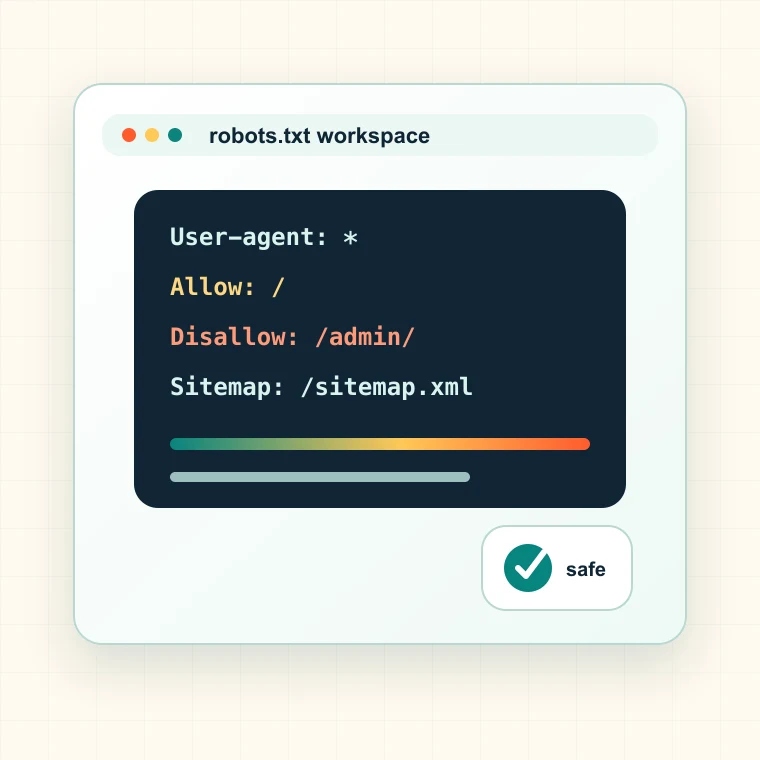
クローラーのアクセスを明確に伝え、価値の低いパスを抑えながら重要なページを保護します。インデックス登録したいページをブロックせず、サイトマップによる発見も案内するrobots.txtルールを作成できます。
ツールを開く
代替URLを手動で入力するかURLパターンを使ってhreflangタグを作成し、ローカライズページから適切な言語・地域のページやx-defaultの代替先を検索エンジンに伝えます。
ツールを開く