robots.txt 產生器

為搜尋引擎產生清楚的 robots.txt 檔案。

建立能清楚說明爬蟲存取方式的 robots.txt 規則,限制低價值路徑、保留重要頁面並提供 sitemap 探索線索,同時避免封鎖應該被索引的頁面。
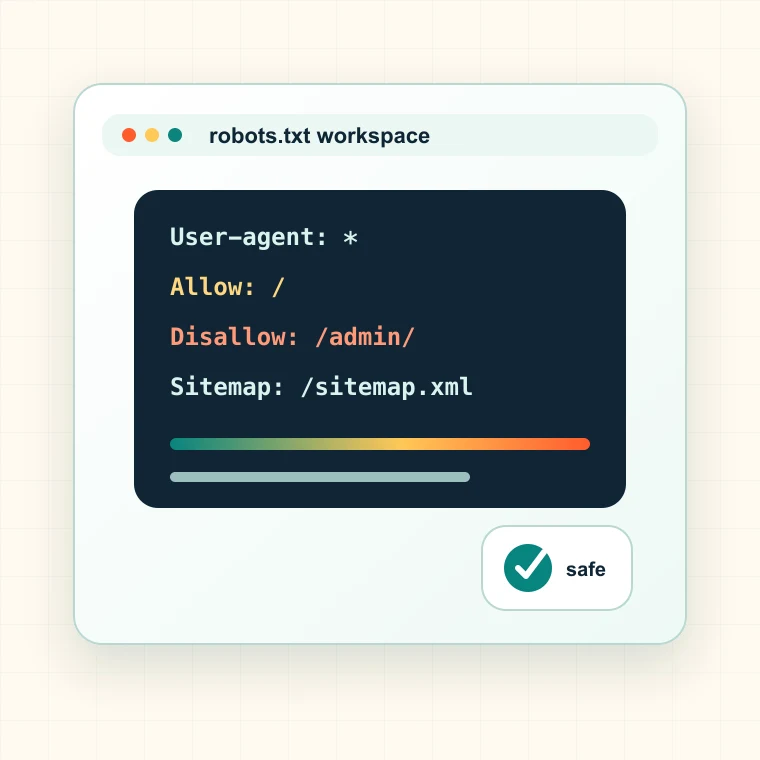
简單且適合 SEO 的預設規則自定義 allow 與 disallow 路徑Sitemap 指令支持Crawl delay 选項
robots.txt 產生器介面:顯示爬蟲存取規則、sitemap 參照,以及允許和禁止路徑預覽
站点 URL爬蟲規則允许與禁止路徑robots.txt 預覽驗證下一步

工具輸入

當後端需要檢查首頁或站點入口時使用。
填入 XML sitemap 或 sitemap index 位址。
選擇後端讀取 URL、貼上文字、手動欄位或 sitemap。
用於 robots 或可索引性檢查的爬蟲身份。
可選抓取延遲,單位秒,範圍 1 到 60。

結果

執行工具後,這裡會顯示分析結果、匯出與下一步動作。

這個工具檢查什么

產生器會根據網站 URL、sitemap URL、爬蟲身分、允許與禁止規則,以及選填的抓取延遲,建立易讀的 robots.txt 草稿。它重視規則清楚易懂,避免設計過於巧妙的封鎖模式。

  • 保留輸入、輸出和證據欄位,便於後續交接。
  • 優先檢查會影響索引、點擊或抓取預算的信號。
  • 把模板級問題和單頁問題分開處理。
  • 對高价值頁面記錄下一步修復动作。

什么時候使用它

在新網站上線、重整私有路徑、清理抓取陷阱,或評估篩選、結帳、搜尋和內部頁面是否應被抓取之前使用。

  • 保留輸入、輸出和證據欄位,便於後續交接。
  • 優先檢查會影響索引、點擊或抓取預算的信號。
  • 把模板級問題和單頁問題分開處理。
  • 對高价值頁面記錄下一步修復动作。

如何解讀結果

robots.txt 是抓取指令,不保證頁面會被索引。禁止抓取的 URL 仍可能透過連結被發現;允許抓取的 URL 也可能帶有 noindex,或 canonical 到其他頁面。

  • 保留輸入、輸出和證據欄位,便於後續交接。
  • 優先檢查會影響索引、點擊或抓取預算的信號。
  • 把模板級問題和單頁問題分開處理。
  • 對高价值頁面記錄下一步修復动作。

常见錯誤

危害最大的 robots 錯誤通常是範圍過廣的規則,導致資源、本地化區域、產品頁甚至整個網站被封鎖。小小的語法變更也可能造成流量事故。

  • 保留輸入、輸出和證據欄位,便於後續交接。
  • 優先檢查會影響索引、點擊或抓取預算的信號。
  • 把模板級問題和單頁問題分開處理。
  • 對高价值頁面記錄下一步修復动作。

下一步怎么做

部署前先檢查草稿、測試範例 URL 並抓取關鍵路徑。安全的 robots.txt 檔案應容易說明,也容易驗證。

  • 保留輸入、輸出和證據欄位,便於後續交接。
  • 優先檢查會影響索引、點擊或抓取預算的信號。
  • 把模板級問題和單頁問題分開處理。
  • 對高价值頁面記錄下一步修復动作。
  • 記錄 URL 群組、負責人、預期影響、驗證步驟和下一步發布決策,讓結果變成可執行的修復票據,而不是又一份匯出的表格。
常見問題

robots.txt 產生器 常見問題

圍繞抓取規劃、metadata 檢查與 SEO 交接的快速解答。

Robots.txt 產生器 適合什么時候用?

不可靠。robots.txt 控制抓取,不控制索引。若需將頁面從索引移除,請在可抓取頁面上使用 noindex,或採用適當的移除流程。

這個工具的結果可以直接發布吗?

對公開搜尋爬蟲而言,通常應封鎖結帳和帳戶頁;但要確認寬泛規則不會連應參與排名的產品、集合或文件路徑也一併封鎖。

它和完整技術抓取有什么區别?

應該。加入 sitemap 指令可協助爬蟲找到 sitemap 檔案,尤其適合大型網站或使用多個 sitemap index 的網站。

發現問題後下一步做什么?

只有伺服器負載確實需要時才設定 crawl delay。有些爬蟲會忽略它;過度限制也可能拖慢需要頻繁更新網站的內容探索。

robots.txt 產生器

把單点工具結果轉成可執行 SEO 流程。

這些工具適合快速判斷,但真正的增長来自把證據、優先級和責任人連接起来。 如果還需要確認其他 SEO 訊號,可以先使用下方相關工具,再進入完整的 Spider Analysis 流程。
