Sitemap URL 提取器
无需手动清理 XML,即可提取 sitemap 中的每个 URL。
将 sitemap XML 或 sitemap index 转换为整洁的 URL 清单,包含来源 sitemap、lastmod、路径分组、重复项检测,以及可直接导出用于抓取规划的数据行。
打开工具
提取 sitemap URL、验证抓取输入、生成元数据、创建 AI 可读的 llms.txt,并在交给 Searvora Spider Analysis 前检查 canonical、可索引性、robots.txt 与 hreflang 信号。
将 sitemap XML 或 sitemap index 转换为整洁的 URL 清单,包含来源 sitemap、lastmod、路径分组、重复项检测,以及可直接导出用于抓取规划的数据行。
打开工具
检查 sitemap 格式、重复条目、跨域 URL、lastmod 规范、抽样状态信号和下一步抓取动作,避免有问题的 sitemap 成为错误输入。
打开工具
创建兼顾目标关键词、页面类型、搜索意图、品牌匹配度和 SERP 可读性的 title tag 候选项,而不是让每个页面都套用同一个标题模板。
打开工具
创建简洁的 llms.txt 草稿,说明哪些公开页面最重要、网站提供什么,以及 AI 助手应如何发现 canonical 产品、价格、文档和资源页面。
打开工具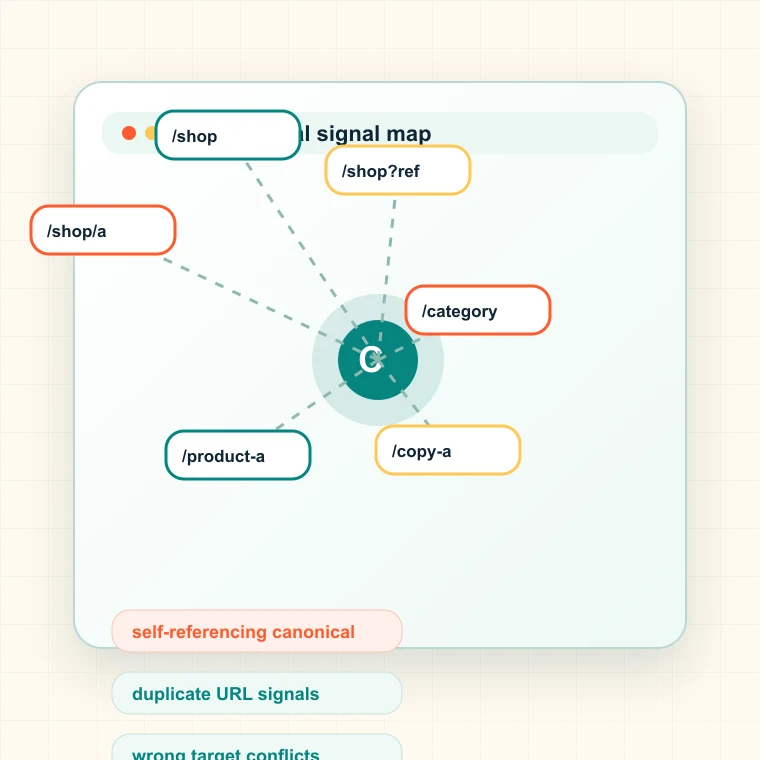
检查 HTML canonical 标签、HTTP Link 响应头、自引用 canonical、跨域目标和相互冲突的规则,避免重复页面分散排名信号。
打开工具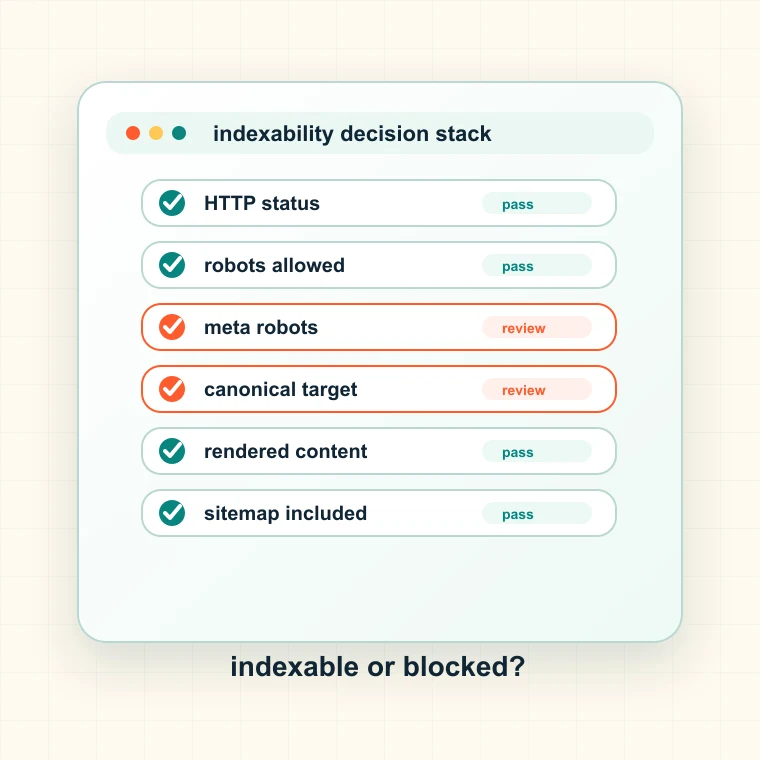
检查状态、重定向、robots.txt 访问权限、meta robots、X-Robots-Tag 和 canonical 信号,说明页面为什么可以或不可以被索引。
打开工具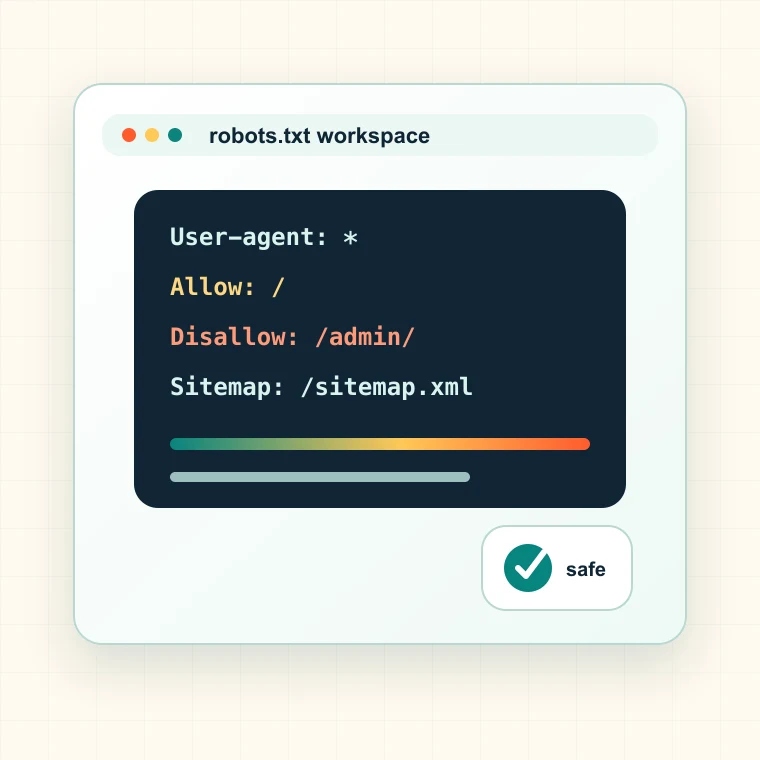
创建清楚表达爬虫访问规则的 robots.txt,限制低价值路径、保留重要页面并提供 sitemap 发现入口,同时避免屏蔽应该被索引的页面。
打开工具
根据手动配置的替代 URL 或 URL 模式生成 hreflang link 标签,让本地化页面将搜索引擎引向正确的语言、地区和 x-default 备用页面。
打开工具