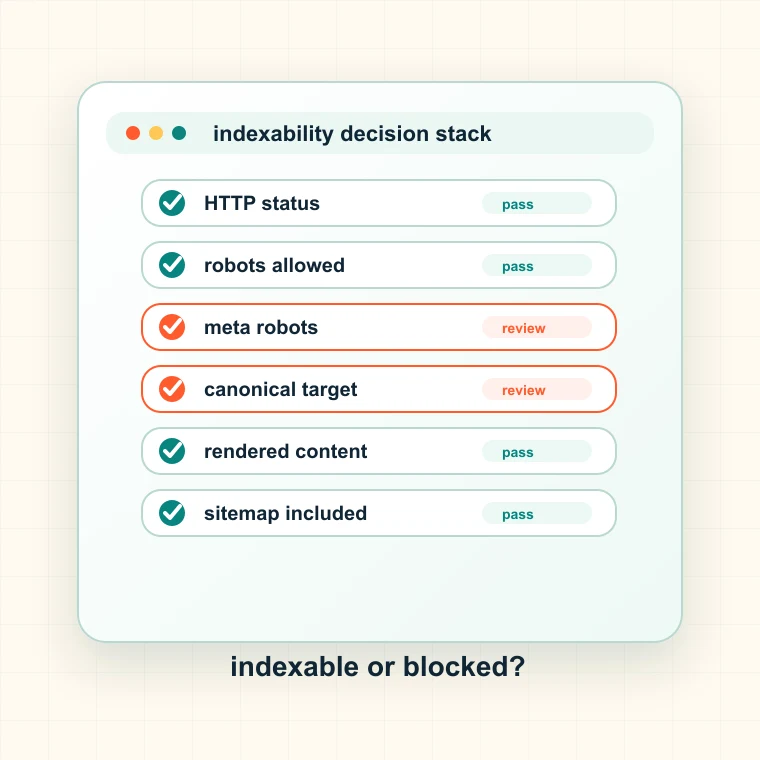
このインデックス登録可否チェッカーで確認できること
ページをインデックス登録できるかを決める技術シグナルを確認します。Googleがページをインデックス登録するとは限りませんが、明らかなブロック要因をすばやく見つけられます。
- HTTPステータスと、リクエストがリダイレクトされたかどうかを確認します。
- 選択したクローラーのrobots.txtアクセスルールを読み取ります。
- meta robotsとX-Robots-Tagのnoindexシグナルを検出します。
- canonicalの指定先と最終URLを比較します。
インデックス登録可否を確認する場面
ページは発見されているのにインデックス未登録のとき、新しいページを公開する前、リリース後にトラフィックが落ちたとき、またはSearch ConsoleでURLが除外されているときに使います。
- 重要なURLのインデックス登録をリクエストする前。
- 移行、リダイレクト、テンプレート変更の後。
- サイトマップに含まれているのに順位が付かないページがあるとき。
- ユーザーには表示されるのに、検索エンジンには見えないページがあるとき。
インデックス登録可否の結果を読み解く方法
技術的にインデックス登録可能でも、品質、重複、権威性、内部リンクが不十分だと実際には登録されないことがあります。このツールではまず技術上の適格性を確認します。
- HTTPエラーは、修正するまで重大なブロック要因になります。
- robots.txtのDisallowはクロールを防ぎますが、URLの発見までは常に防ぐとは限りません。
- noindexは、ページをインデックスに残さないよう検索エンジンに伝えます。
- 別のURLがcanonicalに指定されている場合、現在のURLは検索順位を獲得するURLではない可能性があります。
インデックス登録可否でよくあるミス
多くのチームは、ページがブラウザーで開くかどうかだけを確認します。検索エンジンは異なるシグナルの組み合わせで評価するため、隠れたヘッダーやテンプレートルール1つでセクション全体がブロックされることがあります。
- PDF、メディア、生成ページに設定されたX-Robots-Tagも確認してください。
- Googlebotのルールが異なる場合、1種類のユーザーエージェントだけでテストしないでください。
- サイトマップに載っていればnoindexやrobotsのルールを上書きできると思わないでください。
- canonical化されたページを、独立してインデックス登録される対象として扱わないでください。
インデックス登録可否を確認した後の次のステップ
ページがブロックされている場合は、テンプレートとパスグループを調べます。インデックス登録可否の問題は、ディレクトリ、CMSのページ種類、ローカライズ版にまたがって繰り返されることがあります。
- アクセスルールを整理するにはrobots.txt生成ツールを使います。
- ページが別のURLを指す場合は、canonicalチェッカーを使います。
- インデックス登録可能なページがサイトマップにない場合は、サイトマップ検証ツールを使います。
- サイト全体のブロック要因を担当者ごとにまとめるには、Spider Analysisを使います。
- URLグループ、担当者、期待される効果、検証手順、次の公開判断を記録します。結果を別のスプレッドシートで終わらせず、修正チケットにできます。