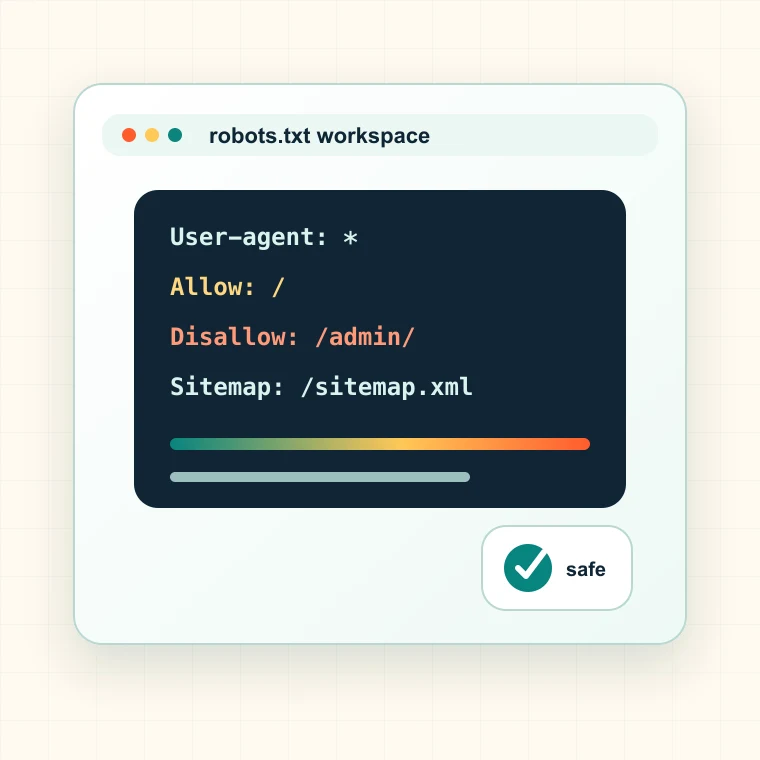
이 robots.txt 생성기가 만드는 항목
사이트 URL, 사이트맵 URL, 크롤러 식별 정보, Allow 규칙, Disallow 규칙, 선택적 크롤링 지연을 바탕으로 읽기 쉬운 robots.txt 초안을 만듭니다. 복잡한 차단 패턴보다 명확성을 우선합니다.
- 일반 크롤러 또는 사용자 지정 크롤러를 위한 user-agent 블록을 만듭니다.
- 사이트맵 지시문을 지원해 URL 발견 신호를 쉽게 찾을 수 있게 합니다.
- Allow 및 Disallow 규칙을 예측하기 쉬운 순서로 추가합니다.
- 배포 전에 검토하고 그대로 복사할 수 있는 초안을 제공합니다.
robots.txt 규칙을 생성할 때
새 사이트를 출시하기 전, 비공개 경로를 재구성할 때, 크롤링 트랩을 정리할 때 또는 패싯, 체크아웃, 검색, 내부 페이지의 크롤링 여부를 검토할 때 사용하세요.
- 새 도메인 또는 서브도메인을 출시하기 전.
- 이커머스 패싯 탐색이 크롤링 트랩을 만든 후.
- 내부 검색, 장바구니, 체크아웃 또는 계정 경로가 크롤링 데이터에 나타날 때.
- AI 및 검색 크롤러 접근 규칙의 기준을 정리할 때.
robots.txt 출력 해석 방법
robots.txt는 크롤링 지시이며 색인을 보장하지 않습니다. Disallow된 URL도 링크를 통해 발견될 수 있고, Allow된 URL에도 noindex가 있거나 다른 표준 URL이 지정될 수 있습니다.
- 광범위한 Disallow 패턴으로 중요한 페이지가 차단되지 않도록 Allow 규칙을 사용하세요.
- Disallow 규칙은 민감한 콘텐츠를 숨기는 용도가 아니라 불필요한 크롤링을 줄이는 데 사용하세요.
- 사이트맵 지시문은 프로덕션의 표준 사이트맵 파일을 가리켜야 합니다.
- 주요 검색 엔진마다 해석이 다르므로 크롤링 지연을 신중하게 사용하세요.
robots.txt에서 흔히 하는 실수
가장 심각한 robots 오류는 에셋, 현지화 영역, 제품 페이지 또는 사이트 전체를 차단하는 광범위한 규칙입니다. 작은 구문 변경이 트래픽 장애로 이어질 수 있습니다.
- robots.txt로 비공개 데이터를 보호하려고 하지 마세요.
- 중요 페이지 렌더링에 필요한 CSS 또는 JavaScript를 차단하지 마세요.
- noindex 태그를 확인하려면 크롤링이 필요한 페이지를 Disallow하지 마세요.
- 샘플 URL을 테스트하지 않고 광범위한 와일드카드 규칙을 배포하지 마세요.
robots.txt 생성 후 다음 단계
초안을 검토하고 샘플 URL을 테스트한 뒤 중요한 경로를 크롤링하고 배포하세요. 안전한 robots.txt는 설명하기 쉽고 검증하기 쉬운 파일입니다.
- 배포 후 중요한 URL을 테스트하려면 색인 가능 여부 검사기를 사용하세요.
- 사이트맵 지시문이 올바른 파일을 가리키는지 사이트맵 검사기로 확인하세요.
- Spider Analysis를 사용해 수익에 중요한 페이지의 차단과 크롤링 트랩을 찾으세요.
- robots.txt를 변경할 때마다 버전 기록을 남기세요.
- URL 그룹, 담당자, 기대 효과, 검증 단계, 다음 게시 결정을 기록하세요. 그래야 결과가 또 다른 스프레드시트로 끝나지 않고 수정 티켓으로 이어집니다.