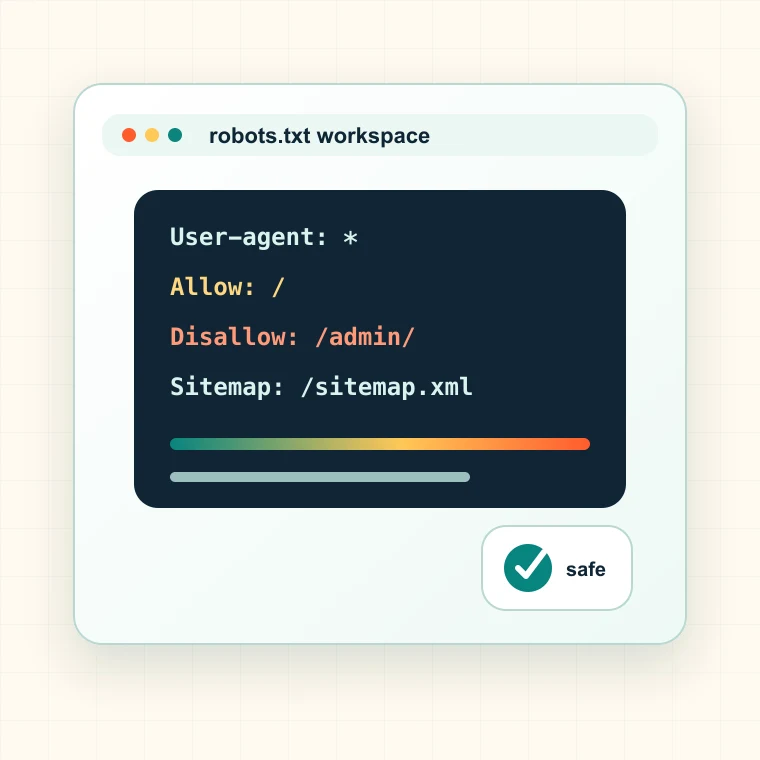
Cosa crea questo generatore di robots.txt
Il generatore crea una bozza leggibile di robots.txt usando URL del sito e della sitemap, identità del crawler, regole Allow e Disallow e, facoltativamente, un ritardo di scansione. Privilegia la chiarezza rispetto a schemi di blocco complessi.
- Crea blocchi user-agent per crawler generici o personalizzati.
- Supporta le direttive Sitemap per rendere più facile trovare i file.
- Aggiunge le regole Allow e Disallow in un ordine prevedibile.
- Mantiene la bozza pronta da copiare e rivedere prima della distribuzione.
Quando generare regole per robots.txt
Usalo prima del lancio di un nuovo sito, della riorganizzazione di percorsi privati, della correzione di trappole di scansione o per verificare se URL con faccette, checkout, ricerca e pagine interne debbano essere scansionati.
- Prima del lancio di un nuovo dominio o sottodominio.
- Dopo che la navigazione e-commerce con faccette ha creato trappole di scansione.
- Quando nei dati di scansione compaiono percorsi di ricerca interna, carrello, checkout o account.
- Quando occorre definire con chiarezza le regole di accesso per crawler IA e motori di ricerca.
Come interpretare l’output di robots.txt
robots.txt fornisce direttive di scansione, non garantisce l’indicizzazione. Un URL vietato può comunque essere scoperto tramite i link e un URL consentito può avere noindex o un canonical diretto altrove.
- Le regole Allow dovrebbero proteggere le pagine importanti da regole Disallow troppo ampie.
- Le regole Disallow dovrebbero ridurre scansioni inutili, non nascondere contenuti sensibili.
- Le direttive Sitemap dovrebbero puntare ai file canonical della sitemap di produzione.
- Usa con cautela il ritardo di scansione, perché i principali motori di ricerca lo interpretano in modo diverso.
Errori comuni in robots.txt
Gli errori robots più gravi sono regole troppo ampie che bloccano risorse, sezioni localizzate, pagine di prodotto o l’intero sito. Una piccola modifica di sintassi può causare un problema di traffico.
- Non usare robots.txt per proteggere dati privati.
- Non bloccare i file CSS o JavaScript necessari per visualizzare le pagine importanti.
- Non vietare la scansione delle pagine per cui occorre leggere i tag noindex.
- Non distribuire regole wildcard troppo ampie senza testare URL di esempio.
Passaggio successivo alla generazione di robots.txt
Rivedi la bozza, testa URL di esempio e scansiona i percorsi critici prima della distribuzione. Il file robots.txt più sicuro è facile da spiegare e da convalidare.
- Usa il verificatore di indicizzabilità per testare gli URL importanti dopo la distribuzione.
- Usa il validatore di sitemap per verificare che le direttive Sitemap rimandino a file corretti.
- Usa Spider Analysis per individuare pagine commerciali bloccate e trappole di scansione.
- Conserva la cronologia delle versioni per ogni modifica a robots.txt.
- Documenta il gruppo di URL, il responsabile, l’impatto previsto, il passaggio di convalida e la prossima decisione di pubblicazione, così il risultato diventa un ticket di correzione invece di un altro foglio esportato.