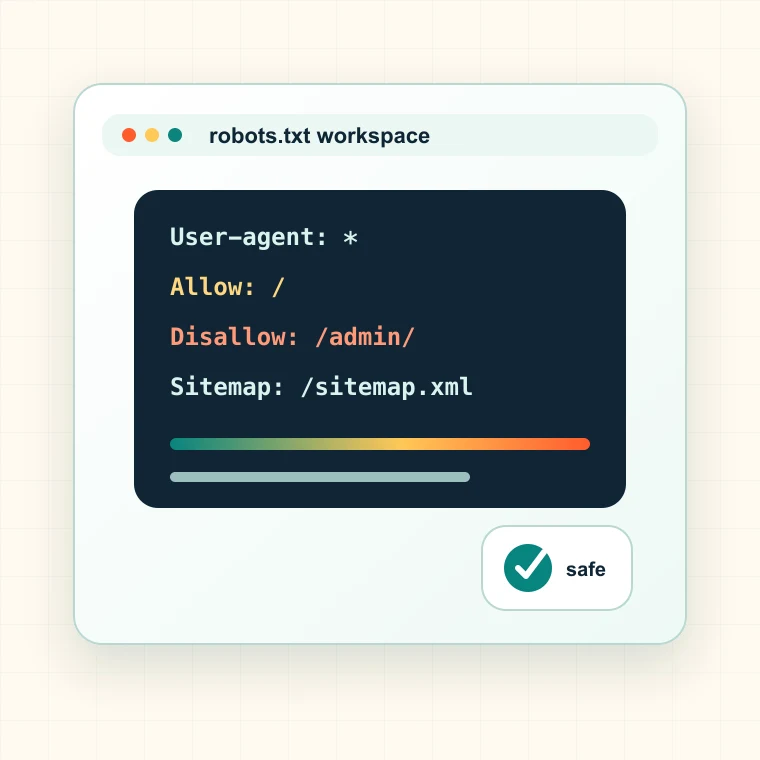
Co tworzy ten generator robots.txt
Generator tworzy czytelny projekt robots.txt na podstawie URL witryny, mapy witryny, tożsamości crawlera i reguł dostępu. Stawia na jasność zamiast skomplikowanych wzorców blokowania.
- Tworzy bloki user-agent dla ogólnych lub niestandardowych crawlerów.
- Obsługuje dyrektywy sitemap, by sygnały odkrywania były łatwiejsze do znalezienia.
- Dodaje reguły allow i disallow w przewidywalnej kolejności.
- Przygotowuje projekt gotowy do skopiowania i wdrożenia.
Kiedy generować reguły robots.txt
Używaj przed uruchomieniem nowej strony, restrukturyzacją ścieżek prywatnych, czyszczeniem pułapek skanowania lub gdy strony koszyka i wyszukiwania pojawiają się w wynikach.
- Przed startem nowej domeny lub subdomeny.
- Gdy nawigacja fasetowa w ecommerce tworzy pułapki skanowania.
- Gdy ścieżki koszyka, zamówienia lub konta pojawiają się w danych skanowania.
- Gdy zasady dostępu dla crawlerów AI i wyszukiwarek wymagają uporządkowania.
Jak interpretować wynik robots.txt
Robots.txt to dyrektywa skanowania, a nie gwarancja braku indeksacji. Zablokowany URL może wciąż zostać odkryty przez linki, a dozwolony może mieć noindex.
- Reguły allow powinny chronić ważne strony przed szerokimi wzorcami disallow.
- Reguły disallow powinny celować w zbędne skanowanie, a nie ukrywać wrażliwe dane.
- Dyrektywy sitemap powinny wskazywać na kanoniczne pliki produkcyjne.
- Crawl delay używaj ostrożnie, bo główne wyszukiwarki interpretują go różnie.
Częste błędy w robots.txt
Najbardziej szkodliwe są zbyt szerokie reguły blokujące zasoby, sekcje językowe, produkty lub całą witrynę. Mała zmiana składni może stać się incydentem w ruchu.
- Nie używaj robots.txt do ochrony prywatnych danych.
- Nie blokuj plików CSS lub JS potrzebnych do renderowania ważnych stron.
- Nie blokuj stron, które muszą być zeskanowane, by robot zobaczył tag noindex.
- Nie wdrażaj szerokich reguł z wieloznacznikami (*) bez testów na próbkach.
Następny krok po wygenerowaniu
Przejrzyj projekt, przetestuj przykładowe URL i sprawdź krytyczne ścieżki przed wdrożeniem. Najbezpieczniejszy plik to taki, który łatwo wyjaśnić i zweryfikować.
- Użyj testera indeksowalności do sprawdzenia ważnych URL po wdrożeniu.
- Użyj walidatora sitemap, by potwierdzić poprawność dyrektyw sitemap.
- Użyj Spider Analysis, by znaleźć zablokowane strony generujące przychód.
- Zachowuj historię wersji dla każdej zmiany pliku robots.txt.
- Dokumentuj grupę URL, właściciela, oczekiwany wpływ i kolejną decyzję wydawniczą, aby wynik stał się zgłoszeniem do poprawki, a nie kolejnym arkuszem.