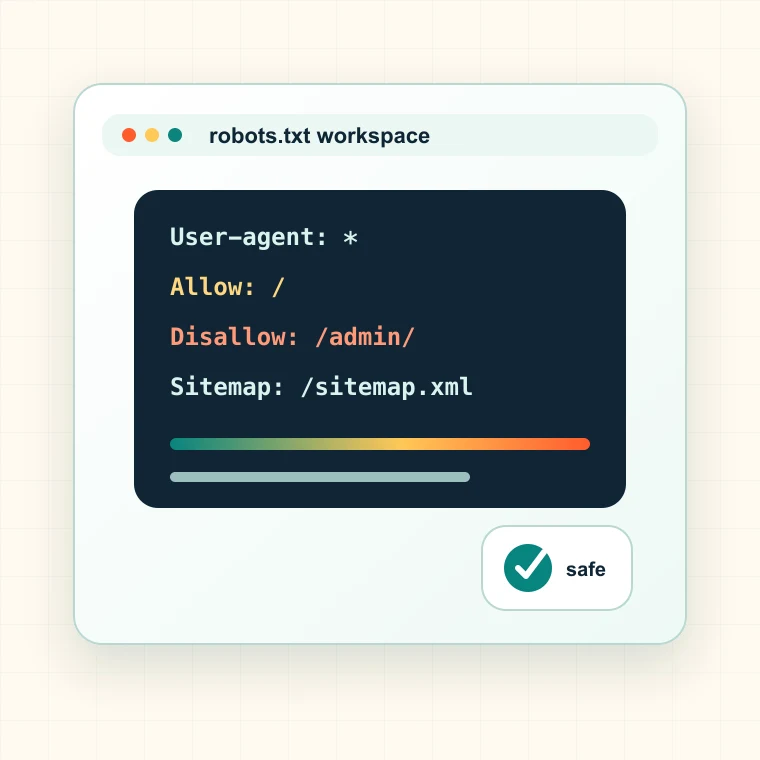
Was dieser robots.txt-Generator erstellt
Der Generator erstellt einen gut lesbaren robots.txt-Entwurf anhand von Website-URL, Sitemap-URL, Crawler-Kennung, Zulassungs- und Sperrregeln sowie einer optionalen Crawl-Verzögerung. Verständliche Regeln haben Vorrang vor komplizierten Sperrmustern.
- Erstellt User-Agent-Blöcke für allgemeine oder benutzerdefinierte Crawler.
- Fügt Sitemap-Anweisungen ein, damit Crawler die Entdeckungssignale leichter finden.
- Ordnet Zulassungs- und Sperrregeln nachvollziehbar an.
- Hält den Entwurf bereit zur Prüfung und Übernahme vor der Bereitstellung.
Wann Sie robots.txt-Regeln erstellen sollten
Verwenden Sie das Tool vor dem Start einer neuen Website, beim Umbau privater Pfade, zum Beseitigen von Crawl-Fallen oder zur Prüfung, ob facettierte, Checkout-, Such- und interne Seiten gecrawlt werden sollen.
- Vor dem Start einer neuen Domain oder Subdomain.
- Wenn facettierte Navigation im E-Commerce Crawl-Fallen erzeugt.
- Wenn interne Suche, Warenkorb, Checkout oder Konto-Pfade in Crawl-Daten auftauchen.
- Wenn Regeln für den Zugriff von KI- und Such-Crawlern eine saubere Ausgangsbasis brauchen.
So interpretieren Sie die robots.txt-Ausgabe
robots.txt steuert das Crawling, garantiert aber keine Indexierung. Eine gesperrte URL kann weiterhin über Links entdeckt werden. Eine erlaubte URL kann dennoch noindex sein oder auf eine andere Canonical-URL verweisen.
- Zulassungsregeln sollten wichtige Seiten vor zu weit gefassten Sperrmustern schützen.
- Sperrregeln sollten unnötiges Crawling begrenzen, keine vertraulichen Inhalte verbergen.
- Sitemap-Anweisungen sollten auf canonical Sitemap-Dateien der Produktionswebsite verweisen.
- Verwenden Sie Crawl-Verzögerungen mit Bedacht, da große Suchmaschinen sie unterschiedlich auslegen.
Häufige Fehler bei robots.txt
Besonders schädlich sind weit gefasste Regeln, die Ressourcen, lokalisierte Bereiche, Produktseiten oder die gesamte Website blockieren. Schon eine kleine Syntaxänderung kann zu einem Traffic-Einbruch führen.
- Verwenden Sie robots.txt nicht, um private Daten zu schützen.
- Blockieren Sie kein CSS oder JavaScript, das für die Darstellung wichtiger Seiten erforderlich ist.
- Sperren Sie keine Seiten, die gecrawlt werden müssen, damit Suchmaschinen deren noindex-Tags sehen.
- Veröffentlichen Sie keine weit gefassten Wildcard-Regeln, ohne Beispiel-URLs zu testen.
Nächster Schritt nach der Erstellung von robots.txt
Prüfen Sie den Entwurf, testen Sie Beispiel-URLs und crawlen Sie wichtige Pfade vor der Bereitstellung. Eine sichere robots.txt-Datei lässt sich leicht erklären und überprüfen.
- Testen Sie wichtige URLs nach der Bereitstellung mit dem Indexierbarkeits-Checker.
- Prüfen Sie mit dem Sitemap-Validator, ob die Sitemap-Anweisungen auf bereinigte Dateien verweisen.
- Finden Sie mit Spider Analysis blockierte umsatzrelevante Seiten und Crawl-Fallen.
- Führen Sie für jede Änderung an robots.txt einen Versionsverlauf.
- Dokumentieren Sie URL-Gruppe, zuständige Person, erwartete Auswirkung, Prüfschritt und nächste Veröffentlichungsentscheidung. So wird aus dem Ergebnis ein konkreter Fehlerbehebungsauftrag statt einer weiteren exportierten Tabelle.