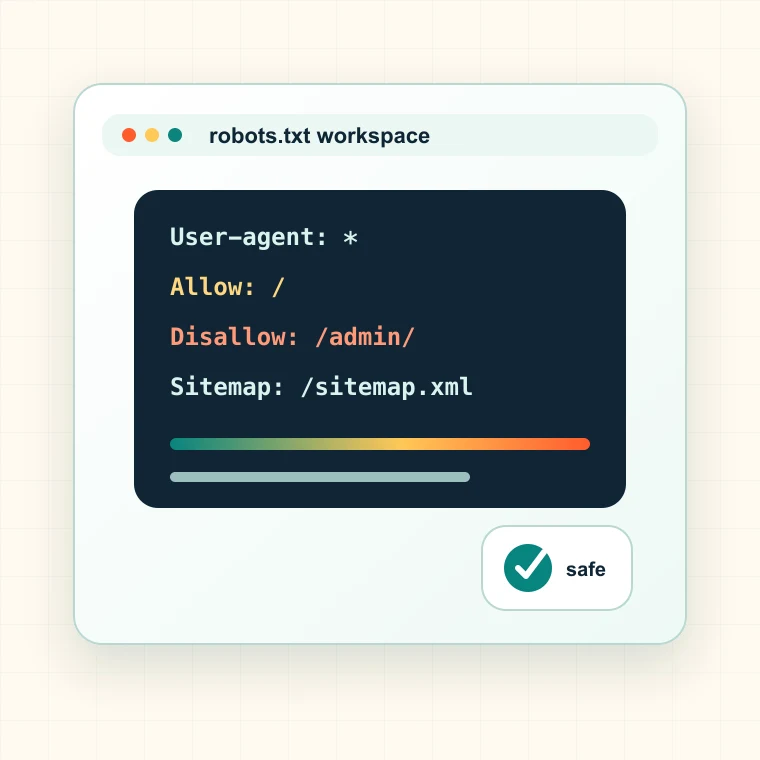
Ce que crée ce générateur de robots.txt
Le générateur crée un brouillon robots.txt lisible à partir de l’URL du site, de celle du sitemap, de l’identité du robot, des règles Allow et Disallow et, si vous le souhaitez, du délai de crawl. Il privilégie la clarté aux règles de blocage sophistiquées.
- Crée des blocs user-agent pour les robots généraux ou personnalisés.
- Prend en charge les directives Sitemap pour faciliter la découverte des fichiers.
- Ajoute les règles Allow et Disallow dans un ordre prévisible.
- Garde le brouillon prêt à copier et à vérifier avant le déploiement.
Quand générer des règles robots.txt
Utilisez cet outil avant le lancement d’un site, la réorganisation de chemins privés, la correction de pièges de crawl ou pour vérifier si les pages à facettes, de commande, de recherche et internes doivent être explorées.
- Avant le lancement d’un nouveau domaine ou sous-domaine.
- Après l’apparition de pièges de crawl liés à la navigation à facettes d’un site e-commerce.
- Lorsque des chemins de recherche interne, de panier, de commande ou de compte apparaissent dans les données de crawl.
- Lorsque les règles d’accès des robots d’IA et des moteurs de recherche doivent être clairement définies.
Comment interpréter le résultat de robots.txt
robots.txt donne des directives de crawl, mais ne garantit pas l’indexation. Une URL interdite peut toujours être découverte via des liens, et une URL autorisée peut malgré tout porter une directive noindex ou avoir une balise canonique pointant ailleurs.
- Les règles Allow doivent protéger les pages importantes contre des règles Disallow trop générales.
- Les règles Disallow doivent cibler le gaspillage de crawl, pas masquer des contenus sensibles.
- Les directives Sitemap doivent pointer vers les fichiers sitemap canoniques de production.
- Utilisez le délai de crawl avec prudence, car les principaux moteurs de recherche l’interprètent différemment.
Erreurs courantes dans robots.txt
Les erreurs robots les plus graves sont des règles générales qui bloquent des ressources, des sections localisées, des pages de produits ou l’ensemble du site. Une petite modification de syntaxe peut provoquer un incident de trafic.
- N’utilisez pas robots.txt pour protéger des données privées.
- Ne bloquez pas les fichiers CSS ou JavaScript nécessaires à l’affichage des pages importantes.
- N’interdisez pas l’exploration des pages dont les balises noindex doivent être lues.
- Ne déployez pas de règles génériques avec jokers sans tester des URL représentatives.
Que faire après avoir généré robots.txt
Vérifiez le brouillon, testez des URL représentatives et explorez les chemins essentiels avant le déploiement. Le fichier robots.txt le plus sûr est facile à expliquer et à valider.
- Utilisez le vérificateur d’indexabilité pour tester les URL importantes après le déploiement.
- Utilisez le validateur de sitemap pour vérifier que les directives Sitemap pointent vers des fichiers corrects.
- Utilisez Spider Analysis pour repérer les pages commerciales bloquées et les pièges de crawl.
- Conservez l’historique des versions de chaque modification de robots.txt.
- Consignez le groupe d’URL, le responsable, l’impact attendu, l’étape de validation et la prochaine décision de publication afin de transformer le résultat en ticket de correction plutôt qu’en un énième tableur exporté.