Technische Voraussetzungen und Indexierungsblocker prüfen
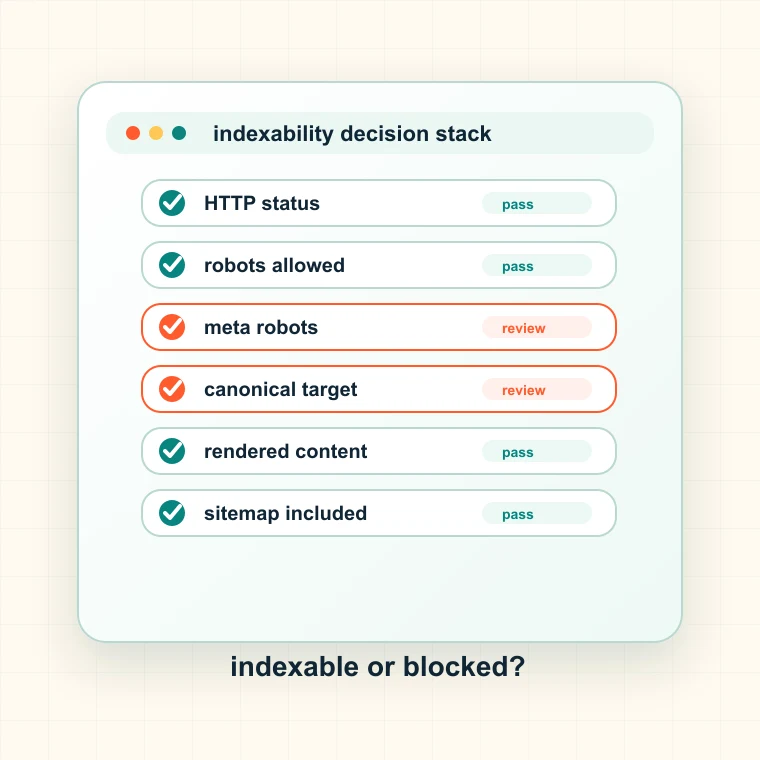
Der Checker prüft die technischen Signale, die bestimmen, ob eine Seite indexiert werden kann. Er verspricht nicht, dass Google die Seite indexiert, macht aber offensichtliche Hindernisse schnell sichtbar.
- Prüft den HTTP-Status und ob eine Weiterleitung erfolgt ist.
- Prüft den Zugriff über robots.txt für die ausgewählte Crawler-Kennung.
- Erkennt noindex-Signale in Meta-Robots-Tags und im X-Robots-Tag.
- Vergleicht Canonical-Ziele mit der endgültigen URL.
Wann Sie die Indexierbarkeit prüfen sollten
Verwenden Sie das Tool, wenn eine Seite entdeckt, aber nicht indexiert wurde, eine neue Seite starten soll, der Traffic nach einer Veröffentlichung sinkt oder die Search Console ausgeschlossene URLs meldet.
- Vor dem Einreichen wichtiger URLs zur Indexierung.
- Nach Migrationen, Weiterleitungen oder Änderungen an Vorlagen.
- Wenn eine Sitemap Seiten enthält, die weiterhin nicht ranken.
- Wenn eine Seite für Nutzer erreichbar, für Suchmaschinen aber unsichtbar ist.
So interpretieren Sie Ergebnisse zur Indexierbarkeit
Eine Seite kann technisch indexierbar sein und dennoch nicht indexiert werden, wenn Qualität, Einzigartigkeit, Autorität oder interne Verlinkung schwach sind. Dieses Tool beantwortet zuerst die Frage nach der technischen Eignung.
- HTTP-Fehler blockieren die Indexierung, bis sie behoben sind.
- Eine Sperre in robots.txt verhindert das Crawling, nicht unbedingt die Entdeckung der URL.
- noindex weist Suchmaschinen an, die gecrawlte Seite nicht im Index zu behalten.
- Verweist das Canonical an anderer Stelle hin, ist die aktuelle URL möglicherweise nicht die Ranking-URL.
Häufige Fehler bei der Indexierbarkeit
Viele Teams prüfen nur, ob sich eine Seite im Browser öffnen lässt. Suchmaschinen werten jedoch weitere Signale aus; ein einzelner versteckter Header oder eine Vorlagenregel kann einen ganzen Bereich blockieren.
- Vergessen Sie das X-Robots-Tag auf PDFs, Mediendateien und generierten Seiten nicht.
- Prüfen Sie mehr als einen User-Agent, wenn für Googlebot andere robots-Regeln gelten.
- Gehen Sie nicht davon aus, dass ein Sitemap-Eintrag noindex- oder robots-Regeln außer Kraft setzt.
- Behandeln Sie canonicalisierte Seiten nicht als eigenständige Indexierungsziele.
Nächster Schritt nach der Prüfung der Indexierbarkeit
Wenn eine Seite blockiert ist, untersuchen Sie die Vorlage und die zugehörige Pfadgruppe. Probleme mit der Indexierbarkeit wiederholen sich häufig in Verzeichnissen, CMS-Seitentypen oder Sprachversionen.
- Verwenden Sie den robots.txt-Generator, wenn Zugriffsregeln bereinigt werden müssen.
- Nutzen Sie den Canonical-Checker, wenn eine Seite auf eine andere URL verweist.
- Prüfen Sie mit dem Sitemap-Validator, ob indexierbare Seiten in Sitemap-Feeds fehlen.
- Gruppieren Sie mit Spider Analysis websiteweite Hindernisse und Zuständigkeiten.
- Dokumentieren Sie URL-Gruppe, zuständige Person, erwartete Auswirkung, Prüfschritt und nächste Veröffentlichungsentscheidung. So wird aus dem Ergebnis ein konkreter Fehlerbehebungsauftrag statt einer weiteren exportierten Tabelle.