Segnali tecnici e blocchi all’indicizzazione
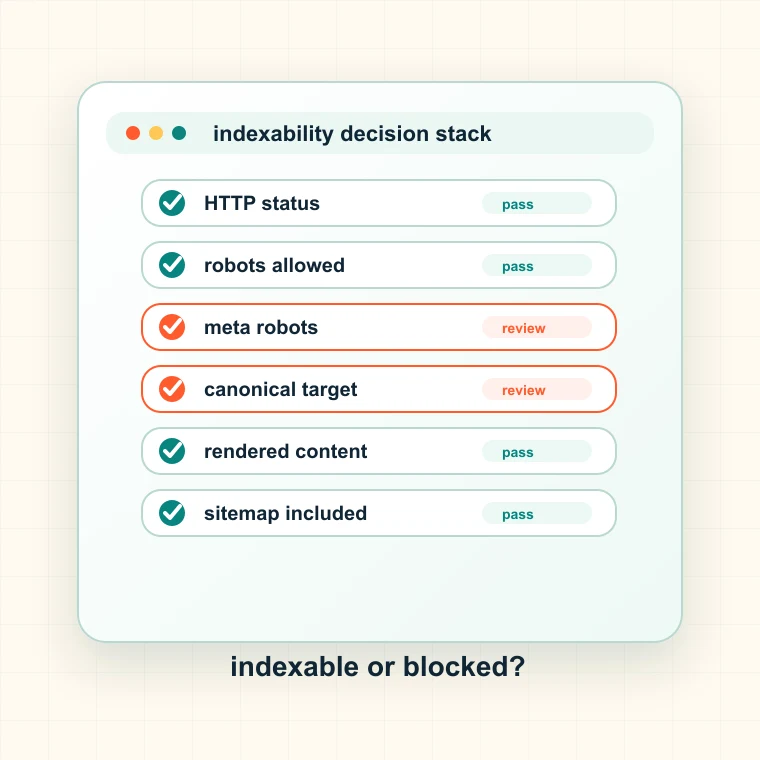
Il verificatore esamina i segnali tecnici che stabiliscono se una pagina può essere indicizzata. Non garantisce che Google la indicizzi, ma fa emergere rapidamente gli ostacoli più evidenti.
- Controlla lo stato HTTP e verifica se la richiesta è stata reindirizzata.
- Legge le regole di accesso di robots.txt per l’identità del crawler selezionato.
- Rileva i segnali noindex nei meta robots e in X-Robots-Tag.
- Confronta le destinazioni canonical con l’URL finale.
Quando controllare l’indicizzabilità
Usalo quando una pagina è stata scoperta ma non indicizzata, prima del lancio di una nuova pagina, dopo un calo di traffico successivo a una release oppure quando Search Console segnala URL escluse.
- Prima di inviare URL importanti per l’indicizzazione.
- Dopo migrazioni, reindirizzamenti o modifiche ai template.
- Quando una sitemap include pagine che continuano a non posizionarsi.
- Quando una pagina sembra disponibile agli utenti ma invisibile ai motori di ricerca.
Come interpretare i risultati di indicizzabilità
Una pagina può essere tecnicamente indicizzabile senza essere indicizzata a causa di qualità, duplicati, autorevolezza o link interni insufficienti. Questo strumento risponde prima di tutto alla domanda sull’idoneità tecnica.
- Gli errori HTTP sono blocchi importanti finché non vengono corretti.
- Un divieto in robots.txt impedisce la scansione, ma non sempre la scoperta dell’URL.
- noindex comunica ai motori di ricerca di non mantenere la pagina nell’indice.
- Se il canonical punta altrove, l’URL corrente potrebbe non essere quello che si posiziona.
Errori comuni di indicizzabilità
Molti team controllano soltanto che la pagina si apra nel browser. I motori di ricerca valutano un insieme diverso di segnali e una regola nascosta in un header o template può bloccare un’intera sezione.
- Non dimenticare X-Robots-Tag nei PDF, nei media e nelle pagine generate.
- Non testare un solo user agent se le regole per Googlebot sono diverse.
- Non dare per scontato che la presenza nella sitemap prevalga su noindex o sulle regole di robots.txt.
- Non considerare le pagine canonicalizzate altrove come destinazioni indicizzabili indipendenti.
Passaggio successivo ai controlli di indicizzabilità
Se una pagina è bloccata, esamina il template e il gruppo di percorsi. I problemi di indicizzabilità spesso si ripetono tra directory, tipi di pagina del CMS o varianti localizzate.
- Usa il generatore di robots.txt quando le regole di accesso devono essere corrette.
- Usa il verificatore di canonical quando la pagina punta a un altro URL.
- Usa il validatore di sitemap quando pagine indicizzabili mancano dai feed della sitemap.
- Usa Spider Analysis per raggruppare i blocchi su tutto il sito e assegnarli ai responsabili.
- Documenta il gruppo di URL, il responsabile, l’impatto previsto, il passaggio di convalida e la prossima decisione di pubblicazione, così il risultato diventa un ticket di correzione invece di un altro foglio esportato.