
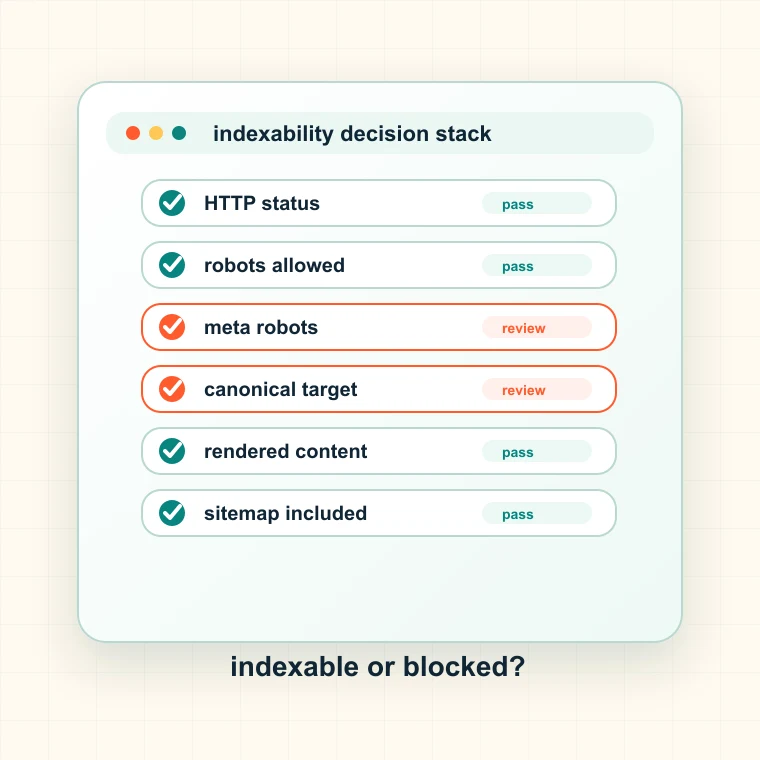
색인 가능성 검사기

전체 크롤링 전에 페이지가 색인 가능한지 확인하세요.

상태, 리디렉션, robots.txt 접근, meta robots, X-Robots-Tag, 표준 URL 신호를 검토해 페이지를 색인할 수 있는지, 그 이유가 무엇인지 설명할 수 있습니다.

HTTP 상태 확인robots 접근 확인meta robots 및 X-Robots 신호표준 URL과 색인 가능 여부 확인
페이지 상태, robots, noindex, 표준 URL, 리디렉션 검사를 보여 주는 색인 가능 여부 검사기 화면
URL 입력크롤러 식별 정보색인 가능 여부 판정차단 신호다음 크롤링 작업

도구 입력

메타데이터를 생성하기 전에 확인할 페이지입니다.
robots.txt 또는 색인 가능 여부를 확인할 때 사용할 크롤러 식별 정보입니다.

결과

도구를 실행하면 분석 결과, 내보내기 항목, 다음 작업이 여기에 표시됩니다.

이 색인 가능 여부 검사기가 확인하는 항목

페이지의 색인 가능 여부를 결정하는 기술 신호를 확인합니다. Google이 페이지를 색인한다고 보장하지는 않지만 명백한 차단 요인을 빠르게 찾을 수 있습니다.

  • HTTP 상태와 요청이 리디렉션되었는지 확인합니다.
  • 선택한 크롤러에 적용되는 robots.txt 접근 규칙을 읽습니다.
  • meta robots 및 X-Robots-Tag의 noindex 신호를 감지합니다.
  • 표준 URL 대상과 최종 URL을 비교합니다.

색인 가능 여부를 확인할 때

페이지가 발견됐지만 색인되지 않았을 때, 새 페이지를 출시하기 전, 릴리스 후 트래픽이 감소했을 때 또는 Search Console에서 URL이 제외되었을 때 사용하세요.

  • 중요 URL의 색인을 요청하기 전.
  • 마이그레이션, 리디렉션 또는 템플릿 변경 후.
  • 사이트맵에 포함됐지만 순위가 없는 페이지가 있을 때.
  • 사용자에게는 보이지만 검색 엔진에는 보이지 않는 페이지가 있을 때.

색인 가능 여부 결과 해석 방법

기술적으로 색인할 수 있는 페이지도 품질, 중복, 권위 또는 내부 링크가 부족하면 실제로 색인되지 않을 수 있습니다. 이 도구는 먼저 기술적인 적격 여부에 답합니다.

  • HTTP 오류는 해결할 때까지 직접적인 차단 요인입니다.
  • robots.txt의 Disallow는 크롤링을 막지만 URL 발견까지 항상 막는 것은 아닙니다.
  • noindex는 페이지를 색인에 유지하지 말라고 검색 엔진에 알립니다.
  • 다른 URL이 표준 URL로 지정되었다면 현재 URL이 검색 순위를 얻을 대상이 아닐 수 있습니다.

색인 가능 여부에서 흔히 하는 실수

많은 팀이 브라우저에서 페이지가 열리는지만 확인합니다. 검색 엔진은 다른 신호 조합을 평가하므로 숨겨진 헤더나 템플릿 규칙 하나가 섹션 전체를 차단할 수 있습니다.

  • PDF, 미디어, 자동 생성 페이지의 X-Robots-Tag도 확인하세요.
  • Googlebot 규칙이 다를 수 있으므로 하나의 사용자 에이전트로만 테스트하지 마세요.
  • 사이트맵에 포함되면 noindex 또는 robots 규칙을 무시할 수 있다고 생각하지 마세요.
  • 표준 URL이 지정된 페이지를 독립적으로 색인될 대상으로 취급하지 마세요.

색인 가능 여부 확인 후 다음 단계

페이지가 차단되었다면 템플릿과 경로 그룹을 확인하세요. 색인 가능 여부 문제는 디렉터리, CMS 페이지 유형 또는 현지화 버전 전반에서 반복될 수 있습니다.

  • 접근 규칙을 정리하려면 robots.txt 생성기를 사용하세요.
  • 페이지가 다른 URL을 가리키면 표준 URL 검사기를 사용하세요.
  • 색인 가능한 페이지가 사이트맵에 없다면 사이트맵 검사기를 사용하세요.
  • 사이트 전체의 차단 요인을 담당자별로 묶으려면 Spider Analysis를 사용하세요.
  • URL 그룹, 담당자, 기대 효과, 검증 단계, 다음 게시 결정을 기록하세요. 그래야 결과가 또 다른 스프레드시트로 끝나지 않고 수정 티켓으로 이어집니다.
FAQ

색인 가능성 검사기 FAQ

크롤 계획, 메타데이터 QA, SEO 인수인계를 위한 빠른 답변입니다.

색인 가능하다는 것은 이미 색인되었다는 뜻인가요?

아니요. 색인 가능하다는 것은 기술적으로 색인될 수 있다는 의미입니다. 품질, 중복, 낮은 권위, 부족한 내부 링크 때문에 Google이 색인하지 않을 수 있습니다.

robots.txt와 noindex의 차이는 무엇인가요?

robots.txt는 크롤링을 제어하고 noindex는 크롤링된 페이지를 색인에 유지할지 제어합니다. 해결하는 문제가 다르며 잘못 사용하면 서로 충돌할 수 있습니다.

표준 URL은 색인 가능 여부에 어떤 영향을 주나요?

페이지가 다른 URL을 표준 URL로 지정하면 검색 엔진이 신호를 통합해 현재 URL 대신 지정된 URL을 색인할 수 있습니다.

Googlebot으로 테스트해야 하나요?

Google 검색 노출이 문제라면 특히 크롤러별 robots 규칙이 다를 때 Googlebot을 사용하세요. 내부 감사를 위해 자체 크롤러 식별 정보로도 테스트하세요.

색인 가능성 검사기

기술적 차단 문제와 콘텐츠 품질 문제를 구분하세요

색인 가능 여부를 확인하면 콘텐츠를 다시 작성하거나 링크를 구축하는 데 시간을 들이기 전에 페이지가 검색 결과에서 경쟁할 수 있는 상태인지 알 수 있습니다. 전체 Spider Analysis를 실행하기 전에 다른 신호를 확인하려면 아래 관련 도구를 사용하세요.