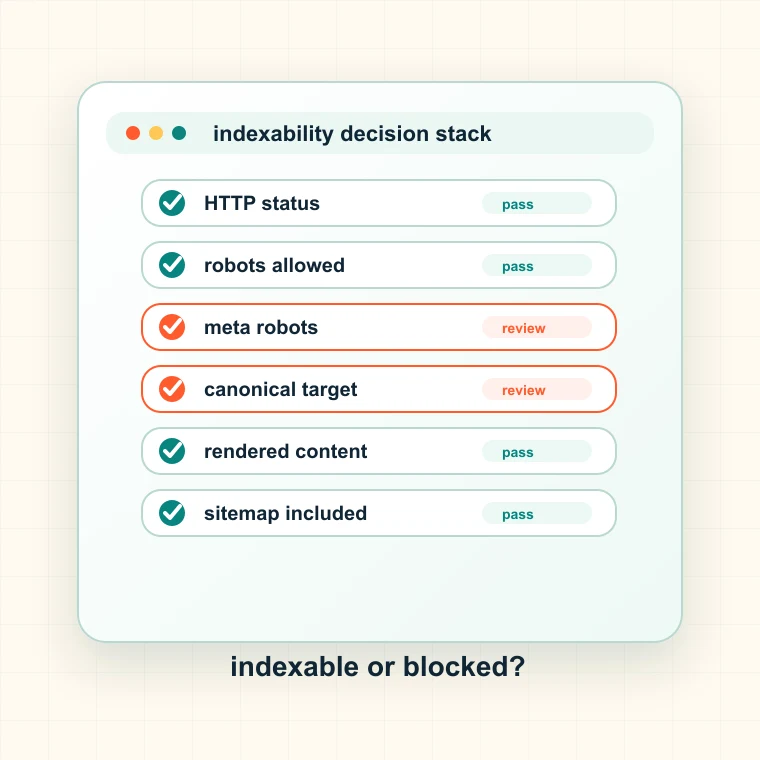
Co sprawdza ten tester indeksowalności
Tester analizuje sygnały techniczne decydujące o tym, czy strona kwalifikuje się do indeksowania. Nie obiecuje indeksacji przez Google, ale wykazuje oczywiste blokady.
- Sprawdza status HTTP i ewentualne przekierowania.
- Odczytuje dostęp w robots.txt dla wybranego crawlera.
- Wykrywa sygnały noindex w meta robots i X-Robots-Tag.
- Porównuje cel kanoniczny z końcowym adresem URL.
Kiedy sprawdzać indeksowalność
Używaj go, gdy strona jest odkryta, ale nie zaindeksowana, gdy nowa strona ma zostać opublikowana, gdy ruch spadnie po wdrożeniu zmian lub gdy Search Console zgłasza wykluczone URL.
- Przed zgłoszeniem ważnych URL do indeksowania.
- Po migracjach, przekierowaniach lub zmianach w szablonach.
- Gdy sitemap zawiera strony, które wciąż nie rankują.
- Gdy strona jest widoczna dla użytkowników, ale niewidoczna dla wyszukiwarek.
Jak interpretować wyniki indeksowalności
Strona może być technicznie indeksowalna, ale nie być zaindeksowana z powodu słabej jakości, duplikacji, braku autorytetu czy słabych linków. To narzędzie odpowiada na pytanie o techniczną kwalifikację.
- Błędy HTTP to twarde blokady wymagające naprawy.
- Blokada w robots uniemożliwia skanowanie, ale nie zawsze odkrycie URL.
- Noindex nakazuje wyszukiwarkom nie przechowywać strony w indeksie.
- Kanonizacja gdzie indziej oznacza, że obecny URL może nie być adresem rankingowym.
Częste błędy przy sprawdzaniu indeksowalności
Zespoły często sprawdzają tylko, czy strona otwiera się w przeglądarce. Wyszukiwarki oceniają inne sygnały, a jedna ukryta reguła w nagłówku może zablokować całą sekcję.
- Nie zapominaj o X-Robots-Tag w plikach PDF i mediach.
- Nie testuj tylko jednego user-agenta, jeśli reguły Googlebot są inne.
- Nie zakładaj, że obecność w sitemap nadpisuje reguły noindex lub robots.
- Nie traktuj stron kanonizowanych jako niezależnych celów indeksowania.
Następny krok po kontroli
Jeśli strona jest zablokowana, sprawdź szablon i grupę ścieżek. Problemy z indeksowaniem często powtarzają się w katalogach lub wariantach językowych.
- Użyj generatora robots.txt, gdy zasady dostępu wymagają poprawy.
- Użyj sprawdzania linków kanonicznych, gdy strona wskazuje na inny URL.
- Użyj walidatora sitemap, gdy indeksowalne strony brakuje w kanałach sitemap.
- Użyj Spider Analysis dla grupowej diagnostyki blokad na całej stronie.
- Dokumentuj grupę URL, właściciela, oczekiwany wpływ i kolejną decyzję wydawniczą, aby wynik stał się zgłoszeniem do poprawki, a nie kolejnym arkuszem.