Проверка индексируемости

Проверьте индексируемость страницы до полного сканирования.

Проверьте статус, перенаправления, доступ robots.txt, meta robots, X-Robots-Tag и canonical-сигналы, чтобы понять, почему страница может или не может попасть в индекс.

Анализ статуса HTTPПроверка доступа в robots.txtСигналы Meta и X-RobotsКонтекст канонической индексации
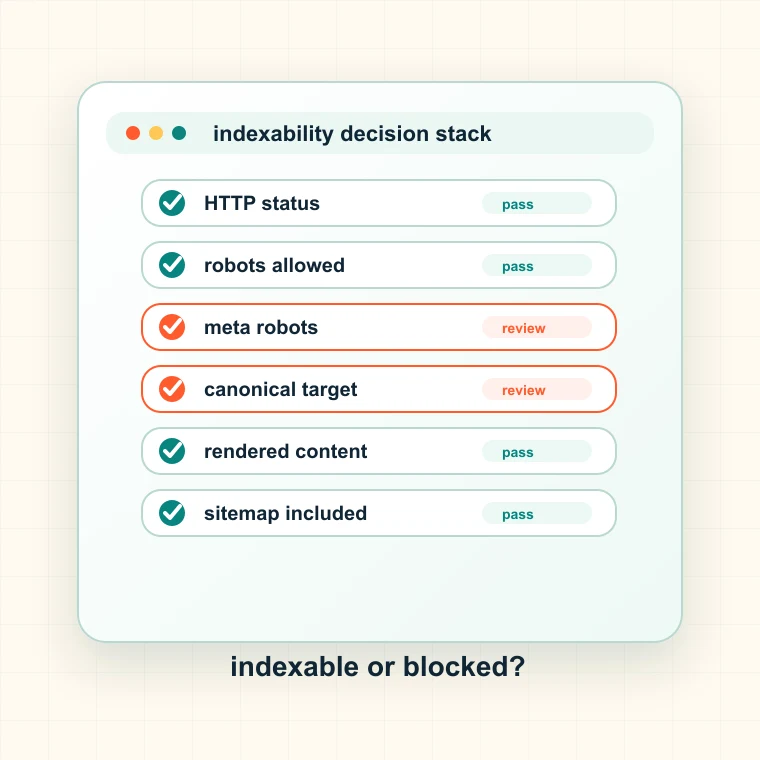
Интерфейс проверки индексируемости со статусом страницы, robots, noindex, canonical и перенаправлениями
Ввод URLИмя краулераВердикт индексацииБлокирующие сигналыДальнейшие шаги

Входные данные

Страница для проверки перед генерацией метаданных.
Имя краулера для проверок robots или индексации.

Результаты

Запустите инструмент, чтобы увидеть результаты анализа, экспорта и рекомендации здесь.

Что проверяет этот инструмент

Он анализирует технические условия для попадания в индекс. Это не гарантия индексации Гуглом, но быстрый поиск явных блокировок.

  • Проверяет статус HTTP и факт редиректа.
  • Читает правила robots.txt для выбранного бота.
  • Находит сигналы noindex в коде и HTTP-заголовках.
  • Сверяет каноническую цель с финальным URL.

Когда проверять индексацию

Если страница найдена, но не в индексе; перед запуском новых разделов; при падении трафика или при ошибках в Search Console.

  • Перед отправкой важных URL на переобход.
  • После миграций или правок в шаблонах.
  • Если страницы есть в карте сайта, но их нет в выдаче.
  • Если сайт доступен пользователям, но 'невидим' для поисковиков.

Как понимать результаты

Страница может быть индексируемой технически, но не попадать в поиск из-за низкого качества или отсутствия ссылок. Начните с техники.

  • Ошибки HTTP — критические блокировки до исправления.
  • Disallow в robots закрывает путь боту, но не всегда скрывает URL.
  • Noindex — прямой запрет на хранение страницы в базе поисковика.
  • Склейка (canonical) означает, что этот URL не выбран основным.

Частые ошибки

Многие смотрят только на браузер. Поисковики видят другой набор сигналов, и один скрытый заголовок может закрыть целый раздел.

  • Не забывайте про X-Robots-Tag в PDF и медиа-файлах.
  • Тестируйте разных ботов, если правила для них отличаются.
  • Карта сайта не отменяет правила noindex или robots.txt.
  • Страницы с каноникалом на другой URL не считаются независимыми целями.

Дальнейшие шаги

Если страница в блоке — проверьте весь тип страниц. Проблемы часто тиражируются на все товары или статьи блога.

  • Используйте генератор robots.txt для правки правил доступа.
  • Проверьте каноникалы, если страница ссылается на другой адрес.
  • Проверьте карту сайта на наличие индексируемых страниц.
  • Используйте Spider Analysis для массовой проверки блокировок.
  • Документируйте задачи для разработчиков с привязкой к данным.
FAQ

Проверка индексируемости FAQ

Короткие ответы про планирование сканирования, проверку метаданных и передачу SEO-задач.

Означает ли 'индексируема' попадание в поиск?

Нет. Индексируемость означает, что страница технически может попасть в индекс. Google всё равно может решить не индексировать её из-за качества, дублирования, низкого авторитета или слабых внутренних ссылок.

В чем разница между robots.txt и noindex?

Robots.txt управляет сканированием. Noindex определяет, должна ли уже просканированная страница оставаться в индексе. Эти директивы решают разные задачи и при неправильном применении могут конфликтовать.

Почему canonical влияет на индексацию?

Если для страницы указан другой URL в качестве canonical, поисковые системы могут объединить сигналы и выбрать целевой canonical вместо индексации текущего URL.

Нужно ли тестировать как Googlebot?

Используйте Googlebot, когда вас интересует видимость в Google, особенно если правила robots различаются для разных краулеров. Для внутренних аудитов также проверяйте собственную идентичность краулера.

Проверка индексируемости

Отделите тех. блокировки от проблем качества.

Проверка индексации скажет, допущена ли страница к участию в поиске вообще. Используйте инструменты ниже.