O que este verificador de indexabilidade analisa
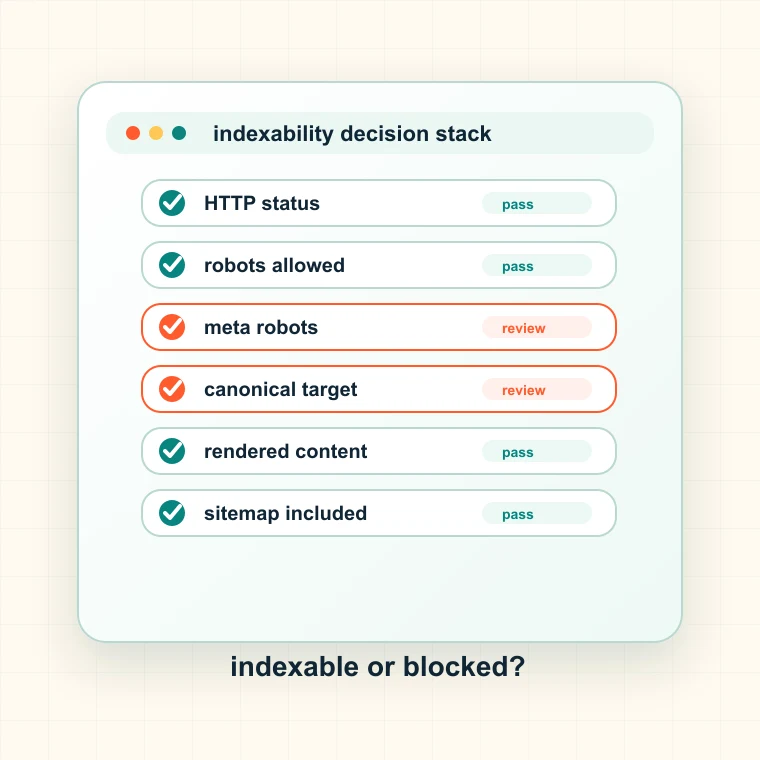
O verificador analisa os sinais técnicos que determinam se uma página está qualificada para ser indexada. Ele não garante que o Google a indexará, mas identifica rapidamente os bloqueios mais evidentes.
- Verifica o status HTTP e se houve redirecionamento da solicitação.
- Lê as regras de acesso do robots.txt para a identificação de rastreador selecionada.
- Detecta sinais noindex em meta robots e X-Robots-Tag.
- Compara os destinos canônicos com a URL final.
Quando verificar a indexabilidade
Use-o quando uma página for descoberta, mas não indexada; antes de lançar uma página nova; quando o tráfego cair após uma versão; ou quando o Search Console indicar URLs excluídas.
- Antes de enviar URLs importantes para indexação.
- Depois de migrações, redirecionamentos ou alterações nos modelos.
- Quando um sitemap incluir páginas que ainda não aparecem nos resultados.
- Quando uma página estiver disponível para os usuários, mas invisível para os mecanismos de busca.
Como interpretar os resultados de indexabilidade
Uma página pode estar tecnicamente apta à indexação e mesmo assim não ser indexada por ter problemas de qualidade, duplicidade, autoridade ou links internos. Esta ferramenta responde primeiro à questão da elegibilidade técnica.
- Erros HTTP são bloqueios efetivos até serem corrigidos.
- Uma regra Disallow no robots.txt impede o rastreamento, mas nem sempre a descoberta da URL.
- A diretiva noindex informa aos mecanismos de busca que não devem manter a página no índice.
- Se a página apontar para outra URL canônica, a URL atual talvez não seja a que aparece nos resultados.
Erros comuns de indexabilidade
Muitas equipes verificam apenas se a página abre no navegador. Os mecanismos de busca avaliam outros sinais, e um cabeçalho oculto ou uma regra de modelo pode bloquear uma seção inteira.
- Não se esqueça do X-Robots-Tag em PDFs, arquivos de mídia e páginas geradas.
- Não teste apenas um agente de usuário se as regras do Googlebot forem diferentes.
- Não presuma que a inclusão no sitemap prevaleça sobre noindex ou sobre as regras do robots.txt.
- Não trate páginas consolidadas em outra URL canônica como destinos indexáveis independentes.
Próxima etapa depois das verificações de indexabilidade
Se uma página estiver bloqueada, analise o modelo e o grupo de caminhos. Problemas de indexabilidade costumam se repetir em diretórios, tipos de página do CMS ou variantes localizadas.
- Use o gerador de robots.txt quando for preciso corrigir as regras de acesso.
- Use o verificador de URLs canônicas quando a página apontar para outra URL.
- Use o validador de sitemap quando páginas indexáveis não estiverem nos arquivos de sitemap.
- Use o Spider Analysis para agrupar bloqueios no site inteiro e atribuí-los aos responsáveis.
- Registre o grupo de URLs, o responsável, o impacto esperado, a etapa de validação e a próxima decisão de publicação. Assim, o resultado vira um chamado de correção, em vez de mais uma planilha exportada.