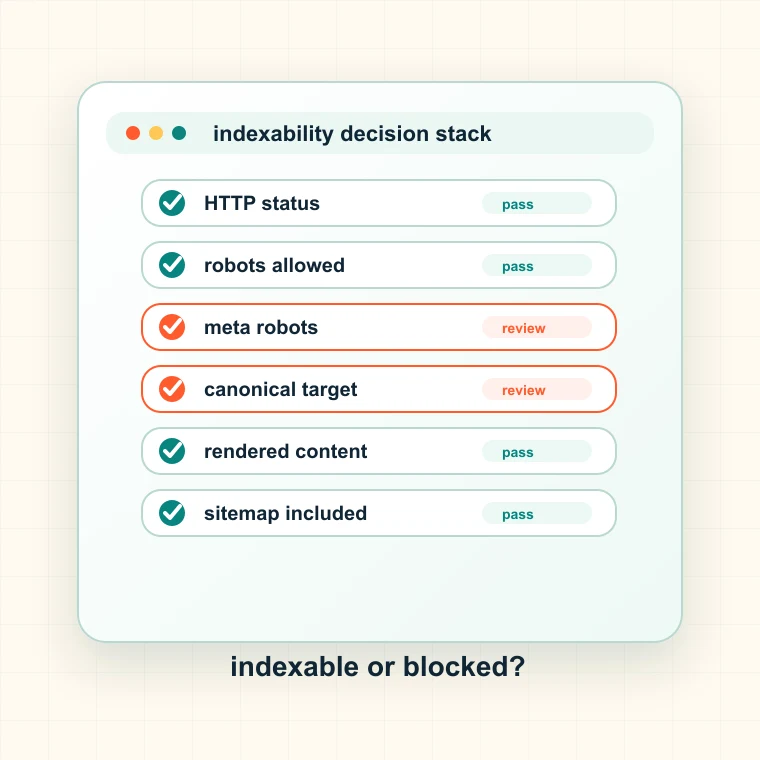
Qué comprueba este verificador de indexabilidad
El comprobador revisa las señales técnicas que determinan si una página puede indexarse. No garantiza que Google la indexe, pero detecta rápidamente los bloqueos evidentes.
- Comprueba el estado HTTP y si la solicitud se redirigió.
- Lee las reglas de acceso de robots.txt para la identidad de rastreador seleccionada.
- Detecta señales noindex en meta robots y X-Robots-Tag.
- Compara los destinos canónicos con la URL final.
Cuándo comprobar la indexabilidad
Úsalo cuando se descubra una página que no se ha indexado, antes de lanzar una página nueva, si baja el tráfico tras una publicación o cuando Search Console indique URL excluidas.
- Antes de enviar URL importantes para su indexación.
- Después de migraciones, redirecciones o cambios en las plantillas.
- Cuando un sitemap incluya páginas que todavía no se posicionan.
- Cuando una página está disponible para los usuarios, pero es invisible para los motores de búsqueda.
Cómo interpretar los resultados de indexabilidad
Una página puede ser técnicamente indexable y aun así no indexarse por problemas de calidad, duplicación, autoridad o enlaces internos. Esta herramienta responde primero a la cuestión de la elegibilidad técnica.
- Los errores HTTP son bloqueos absolutos hasta que se corrijan.
- Una regla Disallow en robots.txt impide el rastreo, pero no siempre el descubrimiento de la URL.
- La directiva noindex indica a los motores de búsqueda que no mantengan la página en el índice.
- Si la página apunta a otra URL canónica, es posible que la URL actual no sea la que se posiciona.
Errores habituales de indexabilidad
Muchos equipos solo comprueban si la página se abre en el navegador. Los motores de búsqueda evalúan otras señales, y una cabecera oculta o una regla de plantilla puede bloquear una sección entera.
- No olvides X-Robots-Tag en archivos PDF, medios y páginas generadas.
- No pruebes con un único agente de usuario si las reglas de Googlebot son distintas.
- No des por hecho que incluir una página en el sitemap anula noindex o las reglas de robots.txt.
- No trates las páginas que apuntan a otra URL canónica como destinos indexables independientes.
Siguiente paso tras las comprobaciones de indexabilidad
Si una página está bloqueada, revisa la plantilla y el grupo de rutas. Los problemas de indexabilidad suelen repetirse en directorios, tipos de página del CMS o variantes localizadas.
- Usa el generador de robots.txt cuando haya que corregir las reglas de acceso.
- Usa el comprobador de URL canónicas cuando la página apunte a otra URL.
- Usa el validador de sitemap cuando falten páginas indexables en los archivos de sitemap.
- Usa Spider Analysis para agrupar los bloqueos de todo el sitio y asignarles responsables.
- Documenta el grupo de URL, la persona responsable, el impacto esperado, el paso de validación y la próxima decisión de publicación. Así, el resultado se convierte en una tarea de corrección y no en otra hoja de cálculo exportada.