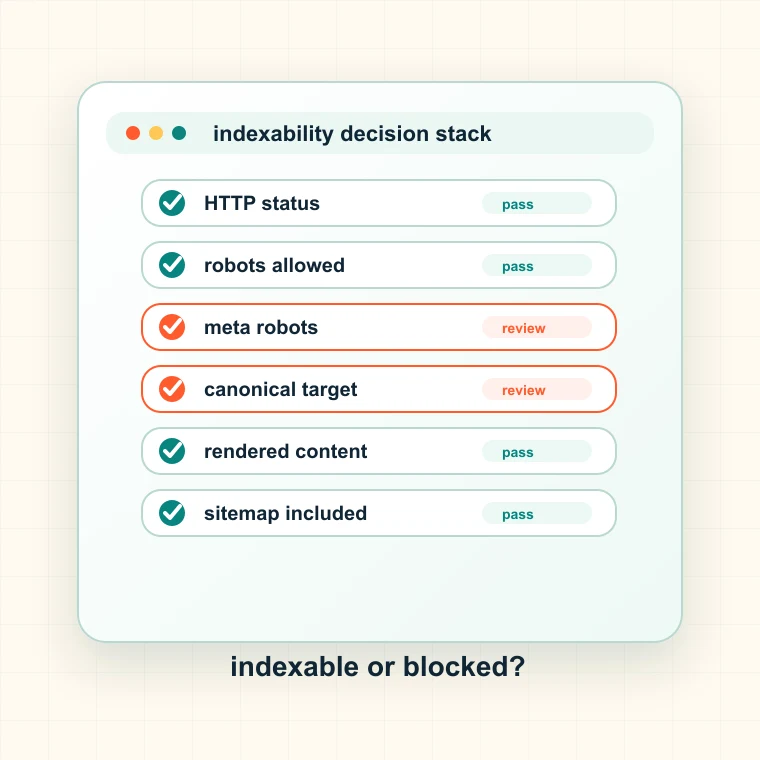
Ce que vérifie cet outil d’indexabilité
Le vérificateur examine les signaux techniques qui déterminent si une page peut être indexée. Il ne garantit pas que Google l’indexera, mais fait rapidement ressortir les blocages évidents.
- Vérifie le statut HTTP et détecte une éventuelle redirection de la requête.
- Vérifie l’accès défini dans robots.txt pour l’identité du robot sélectionné.
- Détecte les directives noindex des balises meta robots et X-Robots-Tag.
- Compare les cibles canoniques à l’URL finale.
Quand vérifier l’indexabilité
Utilisez cet outil lorsqu’une page est découverte mais pas indexée, avant le lancement d’une nouvelle page, après une baisse de trafic liée à une mise en production ou lorsque Search Console signale des URL exclues.
- Avant de demander l’indexation d’URL importantes.
- Après des migrations, des redirections ou des changements de modèle.
- Lorsqu’un sitemap contient des pages qui ne parviennent toujours pas à se positionner.
- Lorsqu’une page semble accessible aux utilisateurs, mais invisible pour les moteurs de recherche.
Comment interpréter les résultats d’indexabilité
Une page peut être techniquement indexable sans être indexée, en raison d’une qualité insuffisante, de doublons, d’un manque d’autorité ou d’un maillage interne faible. Cet outil vérifie d’abord son admissibilité technique.
- Les erreurs HTTP constituent des blocages importants tant qu’elles ne sont pas corrigées.
- Une interdiction dans robots.txt empêche le crawl, mais pas toujours la découverte de l’URL.
- La directive noindex demande aux moteurs de recherche de ne pas conserver la page dans l’index.
- Lorsqu’une balise canonique pointe ailleurs, l’URL actuelle n’est peut-être pas celle qui se positionnera.
Erreurs courantes concernant l’indexabilité
De nombreuses équipes vérifient uniquement si la page s’ouvre dans un navigateur. Les moteurs de recherche évaluent d’autres signaux, et une règle cachée dans un en-tête ou un modèle peut bloquer toute une section du site.
- N’oubliez pas X-Robots-Tag sur les PDF, les médias et les pages générées.
- Ne testez pas un seul user-agent si les règles diffèrent pour Googlebot.
- Ne supposez pas que la présence dans un sitemap annule les règles noindex ou robots.txt.
- Ne considérez pas les pages dont la balise canonique pointe ailleurs comme des cibles indexables indépendantes.
Que faire après les vérifications d’indexabilité
Si une page est bloquée, inspectez son modèle et son groupe de chemins. Les problèmes d’indexabilité se répètent souvent dans des répertoires, des types de page du CMS ou des variantes localisées.
- Utilisez le générateur de robots.txt lorsque les règles d’accès doivent être corrigées.
- Utilisez le vérificateur de balises canoniques si la page pointe vers une autre URL.
- Utilisez le validateur de sitemap lorsque des pages indexables sont absentes des sitemaps.
- Utilisez Spider Analysis pour regrouper les blocages à l’échelle du site et attribuer leur résolution.
- Consignez le groupe d’URL, le responsable, l’impact attendu, l’étape de validation et la prochaine décision de publication afin de transformer le résultat en ticket de correction plutôt qu’en un énième tableur exporté.